כמעט מחצית ממחקרי החתך הציגו סיבתיות [עיבוד AI]
בעיה בכתיבה המדעית: המחקר מצא רק קשר - אבל החוקרים כתבו כאילו מצאו את הסיבה |
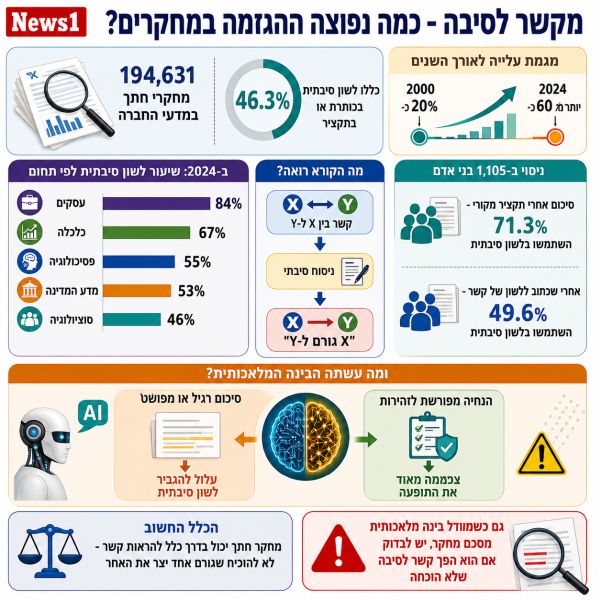
ניתוח של 194,631 מאמרים במדעי החברה מצא כי 46.3% השתמשו בלשון סיבתית אף ששיטת המחקר מאפשרת בדרך כלל לזהות קשר בלבד ● השיעור זינק ליותר מ-60% ב-2024 ● בניסוי נוסף נמצא שגם מודלי בינה מלאכותית עלולים להחריף את ההגזמה כאשר הם מסכמים מחקרים |

האם המחקר באמת הראה שדבר אחד גרם לאחר - או רק ששניהם מופיעים יחד? מחקר חדש מעלה כי ההבחנה הזאת, מהחשובות ביותר במדע, מיטשטשת במספר עצום של מאמרים במדעי החברה - ולעיתים אף מיטשטשת עוד יותר כאשר בינה מלאכותית מתבקשת לסכם אותם.
חוקרים מאוניברסיטת פנסילבניה ניתחו 194,631 מאמרים בתחומי עסקים, כלכלה, פסיכולוגיה, מדע המדינה וסוציולוגיה, שפורסמו בין 1980 ל-2024 והסתמכו באופן בלעדי על מחקרי חתך. הם מצאו כי 46.3% מהמאמרים כללו בכותרת או בתקציר טענה סיבתית הנוגעת לתוצאות המחקר.
מ-20% ליותר מ-60%
המגמה לאורך השנים הייתה חדה במיוחד.
עד שנת 2000 שיעור מחקרי החתך שבהם זוהתה לשון סיבתית נותר יציב יחסית סביב 20%. לאחר מכן החל לעלות במהירות, וב-2024 כבר עבר את רף 60% - כמעט פי שלושה בתוך פחות מרבע מאה.
החוקרים הגדירו מראש מחקרי חתך ככאלה שבהם המשתנים נמדדים בנקודת זמן אחת, ללא רכיב אורכי, ניסויי או מעין-ניסויי. מחקר כזה יכול להראות ששני משתנים מופיעים יחד, אבל בדרך כלל אינו יכול לקבוע מה קדם למה או לשלול לחלוטין גורם שלישי שמסביר את שניהם.
המחקר לא כלל שיטות תצפיתיות מיוחדות, כמו משתני עזר או רגרסיית אי-רציפות, שיכולות בתנאים מסוימים לתמוך בהסקה סיבתית. בכך ניסו החוקרים לצמצם ככל האפשר מצבים שבהם ניסוח סיבתי עשוי להיות מוצדק למרות היעדר ניסוי אקראי.
עסקים בראש הרשימה
התופעה הופיעה בכל חמשת התחומים שנבדקו, אך בעוצמה שונה.
ב-2024 זוהתה לשון סיבתית ב-84% ממחקרי החתך בתחום העסקים. בכלכלה עמד השיעור על 67%, בפסיכולוגיה על 55%, במדע המדינה על 53% ובסוציולוגיה על 46%.
גם כתבי עת יוקרתיים לא היו חסינים. החוקרים מצאו שהשימוש בלשון סיבתית הופיע בשיעורים משמעותיים גם בכתבי העת המובילים, ובממוצע היה אפילו נפוץ מעט יותר בכתבי עת בעלי מקדם השפעה גבוה.
כלומר, אין מדובר רק בתופעה של כתבי עת שוליים או מחקרים באיכות נמוכה.
הקוראים השלימו את הסיבתיות בעצמם
בשלב הבא ביקשו החוקרים לדעת אם הבחירה במילים באמת משנה את האופן שבו הציבור מבין מחקר.
לשם כך גויסו 1,105 משתתפים, שחולקו באקראי לכמה תנאים וקראו אחד מ-28 תקצירי מחקרים שפורסמו בכתבי עת מובילים. חלק קראו את התקציר המקורי, אחרים קיבלו גרסה שבה הניסוחים הסיבתיים הוחלפו בלשון המתארת קשר בלבד, וקבוצות נוספות קיבלו גם הערה מתודולוגית או אזהרה מפני הסקה סיבתית.
הבדלים בניסוח אכן השפיעו.
כאשר התקציר נוסח בלשון של קשר בלבד, או כאשר צורפה אליו הבהרה מתודולוגית, המשתתפים נטו פחות לומר שהמחקר סיפק ראיות לסיבתיות.
אבל גם אחרי התיקון נותרה נטייה חזקה להסיק סיבה.
71% השתמשו בעצמם בלשון סיבתית
כאשר המשתתפים התבקשו לסכם בעצמם את המחקר, 71.3% מהסיכומים שנכתבו לאחר קריאת התקציר המקורי כללו ניסוח סיבתי.
כאשר התקציר שוכתב במפורש ללשון שאינה סיבתית, השיעור ירד ל-49.6%. עם הערה מתודולוגית הוא עמד על 64.2%, ועם אזהרת בינה מלאכותית על 59.4%.
כלומר, אפילו כאשר הטקסט המדעי עצמו נזהר, כמחצית מהקוראים עדיין הפכו את הקשר לסיבה כאשר תיארו אותו במילים שלהם.
החוקרים רואים בכך עדות לכך שהבעיה אינה נובעת רק מהמחברים. לבני אדם עצמם יש נטייה אינטואיטיבית לפרש קשרים כסיבתיים.
ואז נכנסה הבינה המלאכותית
בשלב נוסף בדקו החוקרים מה קורה כאשר מודל שפה מסכם את אותם מחקרים.
בניסוי הראשון קיבל GPT-4.1 את אותם תקצירים שהוצגו למשתתפים האנושיים. כאשר קיבל את הנוסח המקורי, 99.3% מהסיכומים שלו הכילו טענה סיבתית.
שכתוב התקציר ללשון שאינה סיבתית הוריד את השיעור ל-89.8% בלבד. הוספת הערה מתודולוגית הפחיתה אותו ל-41.7%, ואזהרה מפורשת מפני הגזמה סיבתית הורידה אותו ל-30.3%.
כלומר, מודל השפה הגיב היטב לאזהרות מפורשות - אבל בלי הנחיה כזאת נטה כמעט תמיד לשמר או לייצר מסגור סיבתי.
חמישה מודלים נבדקו
החוקרים הרחיבו את הבדיקה לחמישה מודלים: GPT-4.1, GPT-5.1, GPT-5.4, DeepSeek Chat-V3.2 ו-Claude Sonnet 4.6.
לכל מודל הוצגו 100 מאמרים בארבעה סוגי הנחיות: סיכום רגיל, סיכום בשפה פשוטה, סיכום המתמקד בהשלכות המעשיות וסיכום "זהיר" המתבקש להדגיש את מגבלות שיטת המחקר. בסך-הכל נותחו 2,000 סיכומים.
התוצאה הייתה תלויה מאוד בניסוח הבקשה.
בהנחיית סיכום רגילה, GPT-4.1 ו-DeepSeek ייצרו שיעור גבוה משמעותית של טענות סיבתיות לעומת המאמרים המקוריים. במודלים האחרים לא נמצא פער מובהק לאחר תיקון לריבוי בדיקות.
אבל כאשר המודלים התבקשו לפשט את הטקסט או להתמקד במה שניתן לעשות בעקבות הממצאים - שיעור הטענות הסיבתיות עלה בכל חמשת המודלים.
דווקא הקיצור והפישוט מסוכנים
זהו אולי אחד הממצאים המעניינים ביותר עבור עיתונאים.
כאשר מבקשים ממודל שפה "להסביר בפשטות", "לכתוב בקצרה" או "לומר מה המשמעות המעשית", הוא נדרש להסיר חלק מהמורכבות המדעית.
אלא שלעיתים המורכבות שנעלמת היא בדיוק ההסתייגות החשובה: "קשור ל-", "עשוי להיות", "לא ניתן לקבוע סיבתיות".
במקומה עלולה להופיע גרסה קלה יותר לקריאה אך חזקה יותר מדעית: "גורם ל-", "מעלה", "משפיע" או "מפחית".
כך פעולה שנראית כמו עריכת לשון בלבד יכולה לשנות למעשה את המשמעות המדעית.
אפשר ללמד את המודל להיזהר
החדשות הטובות הן שהבעיה לא הייתה בלתי נמנעת.
כאשר החוקרים השתמשו בהנחיה "זהירה", שהתמקדה במגבלות המתודולוגיות של המחקר, שיעור הלשון הסיבתית הבלתי מסויגת ירד בממוצע לכ-5% בחמשת המודלים, אם כי הירידה לא הייתה מובהקת באותה מידה ב-GPT-4.1.
המסקנה המעשית היא שהנחיות למודל חשובות מאוד. בקשה כללית ל"סיכום קצר וברור" אינה שקולה לבקשה "סכם בלי להסיק סיבתיות מעבר למה שהמחקר מאפשר".
חוקרים מאוניברסיטת פנסילבניה ניתחו 194,631 מאמרים בתחומי עסקים, כלכלה, פסיכולוגיה, מדע המדינה וסוציולוגיה, שפורסמו בין 1980 ל-2024 והסתמכו באופן בלעדי על מחקרי חתך. הם מצאו כי 46.3% מהמאמרים כללו בכותרת או בתקציר טענה סיבתית הנוגעת לתוצאות המחקר.
מ-20% ליותר מ-60%
המגמה לאורך השנים הייתה חדה במיוחד.
עד שנת 2000 שיעור מחקרי החתך שבהם זוהתה לשון סיבתית נותר יציב יחסית סביב 20%. לאחר מכן החל לעלות במהירות, וב-2024 כבר עבר את רף 60% - כמעט פי שלושה בתוך פחות מרבע מאה.
החוקרים הגדירו מראש מחקרי חתך ככאלה שבהם המשתנים נמדדים בנקודת זמן אחת, ללא רכיב אורכי, ניסויי או מעין-ניסויי. מחקר כזה יכול להראות ששני משתנים מופיעים יחד, אבל בדרך כלל אינו יכול לקבוע מה קדם למה או לשלול לחלוטין גורם שלישי שמסביר את שניהם.
המחקר לא כלל שיטות תצפיתיות מיוחדות, כמו משתני עזר או רגרסיית אי-רציפות, שיכולות בתנאים מסוימים לתמוך בהסקה סיבתית. בכך ניסו החוקרים לצמצם ככל האפשר מצבים שבהם ניסוח סיבתי עשוי להיות מוצדק למרות היעדר ניסוי אקראי.
עסקים בראש הרשימה
התופעה הופיעה בכל חמשת התחומים שנבדקו, אך בעוצמה שונה.
ב-2024 זוהתה לשון סיבתית ב-84% ממחקרי החתך בתחום העסקים. בכלכלה עמד השיעור על 67%, בפסיכולוגיה על 55%, במדע המדינה על 53% ובסוציולוגיה על 46%.
גם כתבי עת יוקרתיים לא היו חסינים. החוקרים מצאו שהשימוש בלשון סיבתית הופיע בשיעורים משמעותיים גם בכתבי העת המובילים, ובממוצע היה אפילו נפוץ מעט יותר בכתבי עת בעלי מקדם השפעה גבוה.
כלומר, אין מדובר רק בתופעה של כתבי עת שוליים או מחקרים באיכות נמוכה.
הקוראים השלימו את הסיבתיות בעצמם
בשלב הבא ביקשו החוקרים לדעת אם הבחירה במילים באמת משנה את האופן שבו הציבור מבין מחקר.
לשם כך גויסו 1,105 משתתפים, שחולקו באקראי לכמה תנאים וקראו אחד מ-28 תקצירי מחקרים שפורסמו בכתבי עת מובילים. חלק קראו את התקציר המקורי, אחרים קיבלו גרסה שבה הניסוחים הסיבתיים הוחלפו בלשון המתארת קשר בלבד, וקבוצות נוספות קיבלו גם הערה מתודולוגית או אזהרה מפני הסקה סיבתית.
הבדלים בניסוח אכן השפיעו.
כאשר התקציר נוסח בלשון של קשר בלבד, או כאשר צורפה אליו הבהרה מתודולוגית, המשתתפים נטו פחות לומר שהמחקר סיפק ראיות לסיבתיות.
אבל גם אחרי התיקון נותרה נטייה חזקה להסיק סיבה.
71% השתמשו בעצמם בלשון סיבתית
כאשר המשתתפים התבקשו לסכם בעצמם את המחקר, 71.3% מהסיכומים שנכתבו לאחר קריאת התקציר המקורי כללו ניסוח סיבתי.
כאשר התקציר שוכתב במפורש ללשון שאינה סיבתית, השיעור ירד ל-49.6%. עם הערה מתודולוגית הוא עמד על 64.2%, ועם אזהרת בינה מלאכותית על 59.4%.
כלומר, אפילו כאשר הטקסט המדעי עצמו נזהר, כמחצית מהקוראים עדיין הפכו את הקשר לסיבה כאשר תיארו אותו במילים שלהם.
החוקרים רואים בכך עדות לכך שהבעיה אינה נובעת רק מהמחברים. לבני אדם עצמם יש נטייה אינטואיטיבית לפרש קשרים כסיבתיים.
ואז נכנסה הבינה המלאכותית
בשלב נוסף בדקו החוקרים מה קורה כאשר מודל שפה מסכם את אותם מחקרים.
בניסוי הראשון קיבל GPT-4.1 את אותם תקצירים שהוצגו למשתתפים האנושיים. כאשר קיבל את הנוסח המקורי, 99.3% מהסיכומים שלו הכילו טענה סיבתית.
שכתוב התקציר ללשון שאינה סיבתית הוריד את השיעור ל-89.8% בלבד. הוספת הערה מתודולוגית הפחיתה אותו ל-41.7%, ואזהרה מפורשת מפני הגזמה סיבתית הורידה אותו ל-30.3%.
כלומר, מודל השפה הגיב היטב לאזהרות מפורשות - אבל בלי הנחיה כזאת נטה כמעט תמיד לשמר או לייצר מסגור סיבתי.
חמישה מודלים נבדקו
החוקרים הרחיבו את הבדיקה לחמישה מודלים: GPT-4.1, GPT-5.1, GPT-5.4, DeepSeek Chat-V3.2 ו-Claude Sonnet 4.6.
לכל מודל הוצגו 100 מאמרים בארבעה סוגי הנחיות: סיכום רגיל, סיכום בשפה פשוטה, סיכום המתמקד בהשלכות המעשיות וסיכום "זהיר" המתבקש להדגיש את מגבלות שיטת המחקר. בסך-הכל נותחו 2,000 סיכומים.
התוצאה הייתה תלויה מאוד בניסוח הבקשה.
בהנחיית סיכום רגילה, GPT-4.1 ו-DeepSeek ייצרו שיעור גבוה משמעותית של טענות סיבתיות לעומת המאמרים המקוריים. במודלים האחרים לא נמצא פער מובהק לאחר תיקון לריבוי בדיקות.
אבל כאשר המודלים התבקשו לפשט את הטקסט או להתמקד במה שניתן לעשות בעקבות הממצאים - שיעור הטענות הסיבתיות עלה בכל חמשת המודלים.
דווקא הקיצור והפישוט מסוכנים
זהו אולי אחד הממצאים המעניינים ביותר עבור עיתונאים.
כאשר מבקשים ממודל שפה "להסביר בפשטות", "לכתוב בקצרה" או "לומר מה המשמעות המעשית", הוא נדרש להסיר חלק מהמורכבות המדעית.
אלא שלעיתים המורכבות שנעלמת היא בדיוק ההסתייגות החשובה: "קשור ל-", "עשוי להיות", "לא ניתן לקבוע סיבתיות".
במקומה עלולה להופיע גרסה קלה יותר לקריאה אך חזקה יותר מדעית: "גורם ל-", "מעלה", "משפיע" או "מפחית".
כך פעולה שנראית כמו עריכת לשון בלבד יכולה לשנות למעשה את המשמעות המדעית.
אפשר ללמד את המודל להיזהר
החדשות הטובות הן שהבעיה לא הייתה בלתי נמנעת.
כאשר החוקרים השתמשו בהנחיה "זהירה", שהתמקדה במגבלות המתודולוגיות של המחקר, שיעור הלשון הסיבתית הבלתי מסויגת ירד בממוצע לכ-5% בחמשת המודלים, אם כי הירידה לא הייתה מובהקת באותה מידה ב-GPT-4.1.
המסקנה המעשית היא שהנחיות למודל חשובות מאוד. בקשה כללית ל"סיכום קצר וברור" אינה שקולה לבקשה "סכם בלי להסיק סיבתיות מעבר למה שהמחקר מאפשר".
|
||||||||||||||

המאמר "Quantifying the prevalence and impact of overreaching causal claims in social science" מאת Calvin Isch, Timothy Dörr, Neil Fasching, Grace Jennings ו-Duncan J. Watts מאוניברסיטת פנסילבניה, פורסם ב-24.8.26 ב-Nature Human Behaviour לאחר ביקורת עמיתים.
עיתונאי וראש מערכת החדשות. חשבון ב-X  ; פייסבוק
|
|
| מועדון VIP | להצטרפות הקלק כאן |
| פורומים News1 / תגובות |
| כללי | חדשות | רשימות | נושאים | אישים | פירמות | מוסדות |
| אקטואליה | מדיני/פוליטי | בריאות | כלכלה | משפט | סדום ועמורה | עיתונות |
| בעיה בכתיבה המדעית: המחקר מצא רק קשר - אבל החוקרים כתבו כאילו מצאו את הסיבה |
| תגובות [ 0 ] |
|
לכל התגובות
 תפוס כינוי יחודי |
||
| חדשות נוספות ברשת |

|
|
||
|
|
|||
|
|
|
||
|
|
|||
|
|
|
||
|
|
|||
|
|
|
||
|
|
|||
|
|
|
||
| ברחבי הרשת / פרסומת |

 מאיר הר-ציון, ישי צימרמן, חנן סמסון, גיא כוכבא, יצחק בן-עקיבא, יאיר תל צור