כיצד לטפל בחולה, באיזה מינון לתת תרופה ומה אומרות ההנחיות הרפואיות: מחקר חדש מספק הצצה רחבה לשאלות שאנשי רפואה מפנים ל
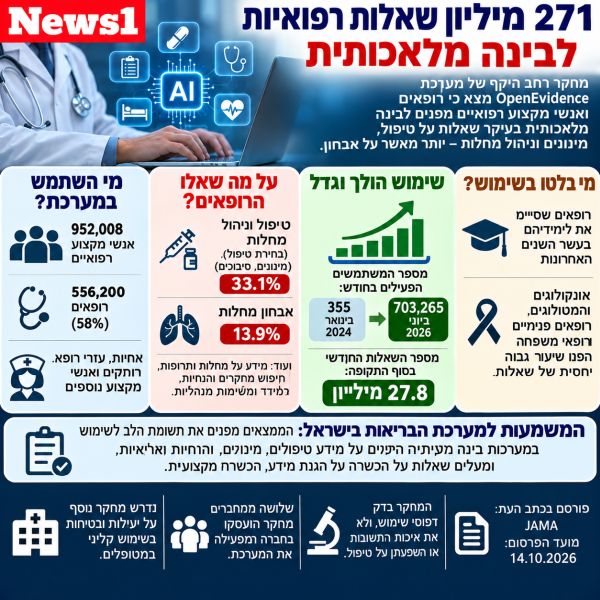
בינה מלאכותית. החוקרים בחנו 271 מיליון שאלות שנשלחו למערכת OpenEvidence במשך שנתיים וחצי, ומצאו כי שאלות הרופאים עסקו בטיפול ובניהול מחלות בשכיחות גבוהה יותר מאשר באבחון.
המחקר פורסם בכתב העת JAMA, בהשתתפות חוקרים מבית הספר לרפואה של הרווארד, ממערכת הבריאות Mass General Brigham וממוסדות נוספים. בצוות השתתפו גם עובדים בחברה המפעילה את המערכת, שסיפקה את הנתונים והייתה מעורבת בניתוחם.
כמעט מיליון משתמשים במערכת אחת
הנתונים נאספו מינואר 2024 עד יוני 2026 וכללו 952,008 אנשי מקצוע רפואיים בארצות הברית. מתוכם, 556,200 היו רופאים, והיתר כללו אחיות בעלות סמכויות טיפול מתקדמות, עוזרי רופא, רוקחים ואנשי מקצוע נוספים. חשבונות המשתמשים אומתו באמצעות מספר זיהוי מקצועי.
OpenEvidence מאפשרת להזין שאלות בשפה חופשית ולקבל תשובות מסכמות המבוססות על ספרות רפואית והנחיות מקצועיות. המחקר בחן את השימוש במערכת הזאת בלבד, ולכן אינו מתאר את כלל השימוש של אנשי רפואה בבינה מלאכותית.
מספר המשתמשים הפעילים בחודש עלה מ-355 בינואר 2024 ל-703,265 ביוני 2026. מספר השאלות החודשי הגיע בסוף התקופה ל-27.8 מיליון. משתמש פעיל הוגדר כמי שהפנה למערכת שאלה אחת לפחות באותו חודש, ולכן אין להסיק שכל המשתמשים נעזרו בה מדי יום.
יותר שאלות על טיפול מאשר על אבחון
לצורך בחינת תוכן השאלות סיווגו החוקרים מדגם של 38.8 מיליון שאלות באמצעות מודל בינה מלאכותית. כלומר, נתוני השימוש הקיפו 271 מיליון שאלות, אך ניתוח מטרותיהן התבסס על מדגם מתוכן.
בקרב הרופאים, 33.1% מהשאלות עסקו בטיפול ובניהול מחלות, ובהם בחירת טיפול, מינוני תרופות והתמודדות עם סיבוכים. לעומת זאת, 13.9% עסקו באבחון. קטגוריות נוספות כללו מידע על מחלות ותרופות, חיפוש מחקרים והנחיות, לימוד ומשימות מינהליות.
הממצא מפנה את תשומת הלב לשימוש שלעיתים זוכה לפחות בולטות בדיון הציבורי: בירור כיצד לטפל במחלה, לצד הניסיון לזהות אותה. עם זאת, תוכן השאלה אינו מלמד אם הרופא אימץ את התשובה או שינה בעקבותיה החלטה רפואית.
|
|
|
|
|
|
הרופאים בתחילת דרכם בלטו בשימוש
רופאים שסיימו את לימודיהם בעשר השנים האחרונות הפנו שיעור גבוה של שאלות ביחס לחלקם בכוח העבודה הרפואי. יחס השימוש שלהם עמד על 2.54 - מדד המשווה בין חלקה של הקבוצה בשאלות לבין חלקה בכוח העבודה, ומשלב את מספר המשתמשים ואת היקף פעילותם.
גם תחום ההתמחות השפיע על דפוסי השימוש. אונקולוגים והמטולוגים, רופאים פנימיים ורופאי משפחה הפנו שיעור גבוה יחסית של שאלות. בקרב רופאי עיניים, רדיולוגים ואורתופדים השיעור היה נמוך יותר. ההבדלים אינם מוכיחים שהמערכת מועילה יותר בתחום מסוים, אלא מתארים כיצד השתמשו בה הקבוצות שנבדקו.
המשמעות האפשרית למערכת הבריאות
המחקר עשוי לעניין את קופות החולים, בתי החולים ומוסדות ההכשרה הרפואית בישראל, משום שהוא בוחן פעילות בפועל ולא רק סקרים על נכונות להשתמש ב בינה מלאכותית.
דפוסי השאלות מצביעים על הצורך לבחון מערכות כאלה גם במתן מידע על טיפולים, מינונים והנחיות רפואיות. לצד זאת עולות שאלות על הכשרת המשתמשים לבדיקת המקורות, על הגנת המידע ועל אחריותו המקצועית של הרופא. המחקר עצמו אינו מספק נתונים על השימוש בארץ.
היקף שימוש אינו הוכחה לאיכות
החוקרים לא בדקו אם התשובות היו נכונות, אם אנשי הרפואה פעלו לפיהן או אם השימוש שיפר את מצבם של המטופלים. גם לא ניתן היה לקבוע אם השאלות נשלחו במהלך מפגש עם חולה, כהכנה לעבודה או לצורך לימוד כללי.
סיווג התוכן נעשה באמצעות בינה מלאכותית, ולכן עלולות להיות בו טעויות. עם זאת, החוקרים ערכו גם בדיקת אימות אנושית במדגם קטן של 200 שאלות. אין מדובר בסיווג שלא נבדק כלל בידי אנשי מקצוע, אך הבדיקה אינה שקולה לקריאה אנושית של מיליוני שאלות.
ניגוד העניינים מחייב אף הוא תשומת לב: שלושה מהמחברים דיווחו על העסקה בחברה המפעילה את OpenEvidence בתקופת המחקר, ובהם המנהל הרפואי הראשי שלה. מעורבותם אינה מבטלת את הממצאים, אך חשוב להציגה לצד הנתונים על צמיחת השימוש במוצר.
|
|



 ; פייסבוק
 בינה מלאכותית / artificial intelligence
 תפוס כינוי יחודי

 נהלים קשיחים ושיקולי אגו הכתיבו שליט...